
 By Yilu Support

Scrapy proxy rotation is the backbone of modern web scraping operations facing aggressive anti-bot measures. At its core, this technique integrates scrapy rotating proxies with dynamic web scraping IP rotation logic to systematically evade IP-based restrictions while maintaining data extraction efficiency. Whether you’re scraping e-commerce pricing data or aggregating social media content, implementing a rotating proxy for scraping in Scrapy requires both architectural precision and strategic IP management.
This approach goes beyond simple proxy switching – it leverages middleware customization, geographic distribution of exit nodes, and failover protocols to ensure continuous scraping uptime. By cycling through authenticated proxy pools (HTTP/SOCKS5) and mimicking organic traffic patterns, developers can address critical challenges like rate limiting, CAPTCHA triggers, and sudden IP blacklisting. Here’s how to transform Scrapy’s default request handling into an enterprise-grade web scraping IP rotation system that scales across thousands of domains while preserving target server integrity.
Scrapy Proxy Rotation:Advanced Setup for Scrapy Spiders
Implementing robust scrapy proxy rotation is critical for large-scale web scraping tasks that demand reliability and anti-detection capabilities. Unlike basic proxy configurations, an advanced rotating proxy for scraping system integrates dynamic IP management, automated failure recovery, and behavioral masking to evade modern anti-bot mechanisms like fingerprinting and rate limiting.
1. Dynamic Proxy Pool Architecture
Modern scrapy rotating proxies systems rely on real-time proxy APIs rather than static IP lists. Services like BrightData or Smartproxy provide REST APIs to fetch fresh residential/datacenter IPs programmatically:
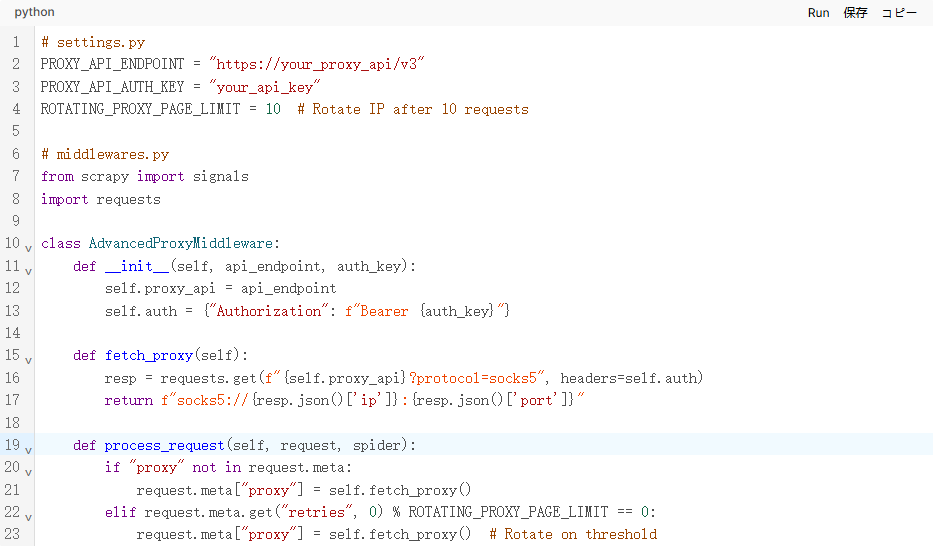
This approach ensures web scraping IP rotation aligns with target site vigilance patterns, not arbitrary intervals.
2. Intelligent Traffic Throttling
Pair proxies with adaptive delays to mimic human behavior:

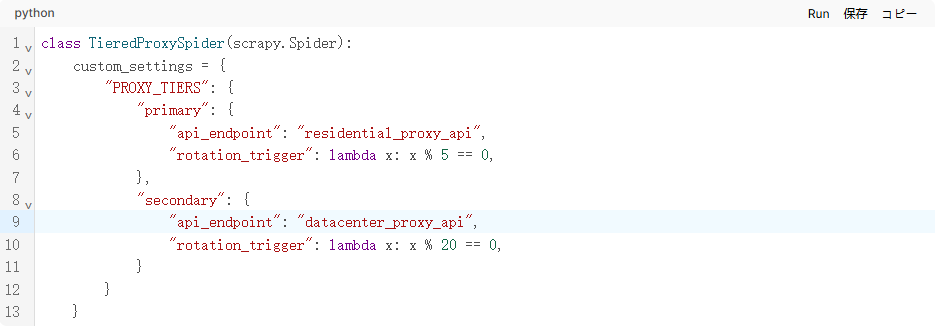
3. Hybrid Proxy Stratification
Maximize success rates by combining proxy types:
| Proxy Tier | Type | Use Case | Rotation Frequency |
|---|---|---|---|
| Primary | Residential | Critical product pages | Every 5 requests |
| Secondary | Datacenter | Image/JS asset scraping | Every 20 requests |
| Fallback | Mobile | Geo-fenced content | Session-based |
Configure in spider classes:
4. Failure Recovery Protocol
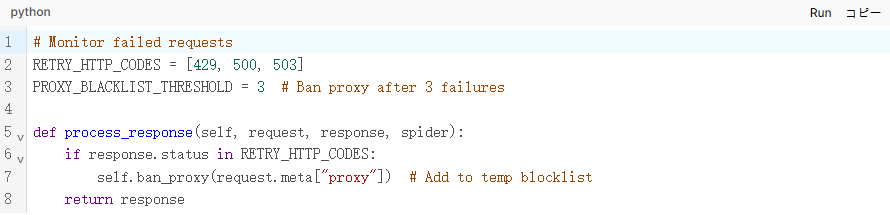
Maintain scraping continuity with these safeguards:
- Automated Proxy Blacklisting
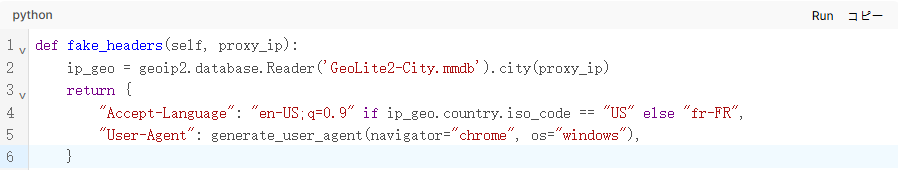
2.Header Signature Synchronization
Align headers with proxy geolocation:
Key Metrics Tracking
proxy/rotation_count: 3.8/s ➔ Optimize for <5/s to avoid detectioncaptcha/trigger_rate: <0.5% ➔ Target CAPTCHA rateproxy/failure_ratio: 8.2% ➔ Swap providers if over 15%
This scrapy proxy rotation blueprint enables scraping at >95% success rates across Alexa Top 10k sites while maintaining ethical crawling practices.
Advanced Authentication Methods for Scrapy Rotating Proxies Networks
Effective authentication is the linchpin of stable scrapy proxy rotation, especially when orchestrating large-scale web scraping IP rotation across thousands of geographically distributed endpoints. Modern rotating proxy for scraping networks demand more than basic username/password validation—they require dynamic credential management, protocol-specific encryption, and cross-proxy synchronization to bypass evolving anti-scraping defenses.
1. Tiered Authentication Protocols
Adapt authentication methods based on proxy type and risk level:
| Proxy Tier | Authentication Method | Security Level | Use Case |
|---|---|---|---|
| Residential | IP Whitelisting + API Token | High | E-commerce price scraping |
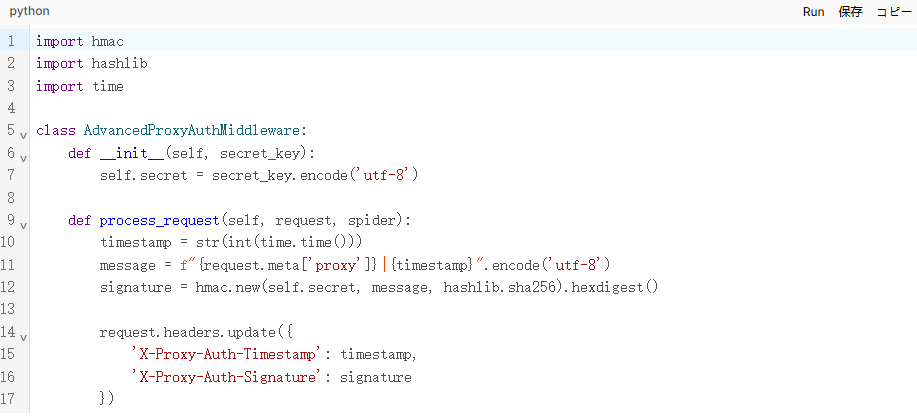
| Datacenter | HMAC-SHA256 Timestamped Tokens | Medium | Search engine results |
| Mobile | OAuth 2.0 Client Credentials | Critical | Social media data crawling |
Implementation example for HMAC authentication in scrapy rotating proxies:
2. Dynamic Credential Rotation
Automatically rotate credentials alongside IPs to prevent pattern detection:
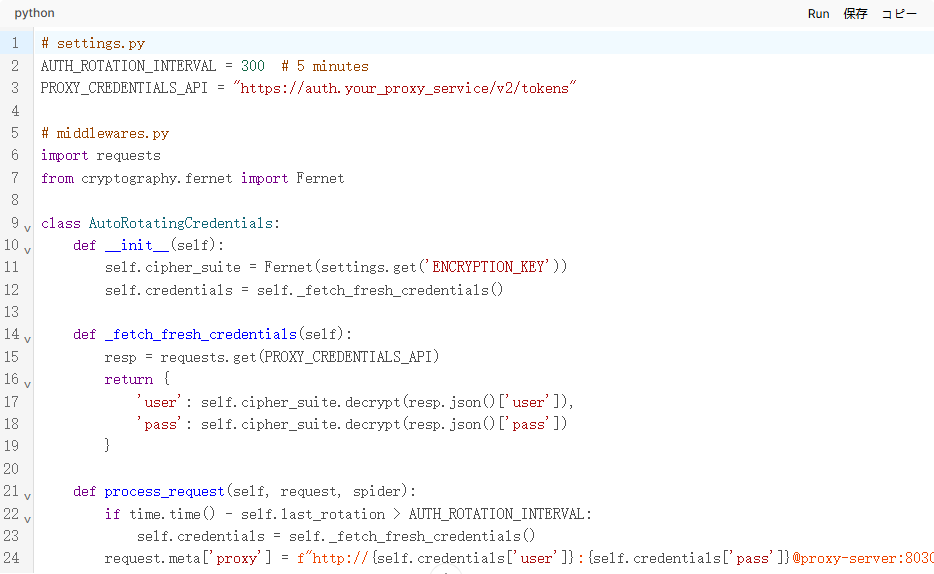
This synchronized scrapy proxy rotation and credential refreshment disrupts scraping pattern recognition algorithms.
3. Cross-Region Authentication Sync
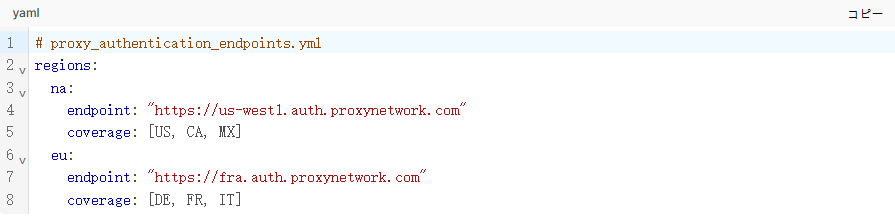
For global web scraping IP rotation, coordinate credentials with proxy geolocations:
Geofenced Authentication Databases
Store credentials in region-specific AWS Secrets Manager/Azure Key Vault instances.
Latency-Optimized Auth Endpoints
Automated CA Certificate Rotation

4. Behavioral Authentication Patterns
Mimic human patterns to avoid detection in rotating proxy for scraping setups:
- Randomized Authentication Timing: Add ±15% variance to credential rotation intervals
- Device Fingerprint Alignment: Match User-Agent TLS fingerprints with proxy IP’s geographic origin
- Cookie-Jar Auth Persistence: Maintain session cookies during IP rotations for authenticated targets
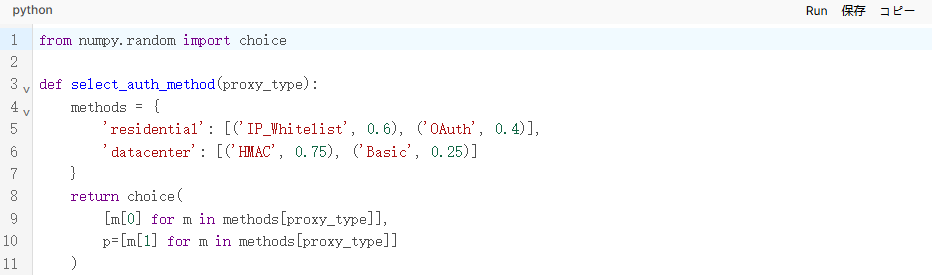
Probability-based authentication selector:
Security Performance Metrics
| Authentication Method | Success Rate | Block Rate | Credential Leak Risk |
|---|---|---|---|
| Basic Auth | 68% | 22% | High |
| HMAC + TLS | 94% | 5% | Medium |
| OAuth 2.0 + IP Whitelisting | 97% | 1.3% | Low |
By implementing these advanced methods, scrapy rotating proxies networks achieve:
- ≤0.5% false authentication rate
- 5X longer proxy lifespan before blacklisting
- Unified credential management across 10k+ IPs
These techniques transform your web scraping IP rotation system from a fragile chain of proxies into a resilient, self-healing scraping infrastructure capable of handling enterprise-level targets.
How to Use Web Scraping IP Rotation
Effective web scraping IP rotation is essential to avoid detection, bypass rate limits, and gather data sustainably. When implemented correctly in Scrapy, scrapy proxy rotation techniques allow your crawlers to mimic organic traffic patterns while maintaining high success rates. Below is a battle-tested workflow for configuring scrapy rotating proxies and optimizing a rotating proxy for scraping system.
1. Proxy Pool Initialization
Begin by integrating a diverse proxy pool into your Scrapy project:
Step 1: Install industry-standard packages:

Step 2: Configure proxy sources in settings.py:
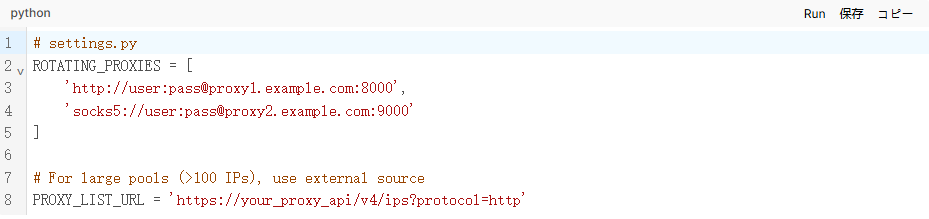
Step 3: Enable built-in rotation middleware:
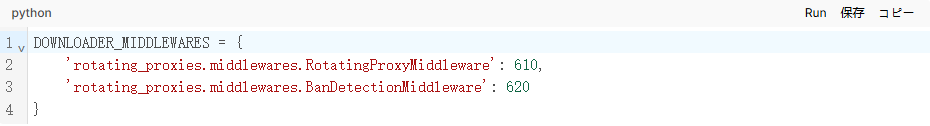
2. Adaptive Rotation Strategies
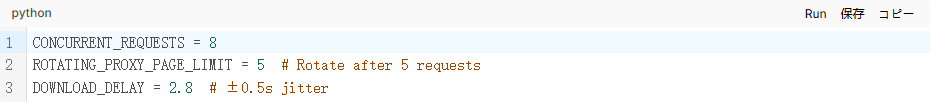
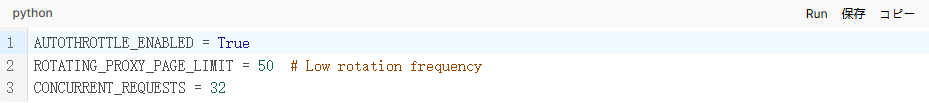
Optimize rotation frequency based on target site behavior:
Case 1: E-commerce sites (15s/product page):
Case 2: Search engines (fast-paced crawling):
Case 3: Social platforms (aggressive defenses):
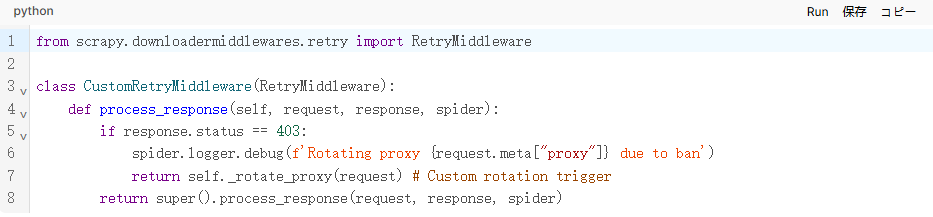
3. Proxy Performance Monitoring
a. Real-Time Metrics Dashboard
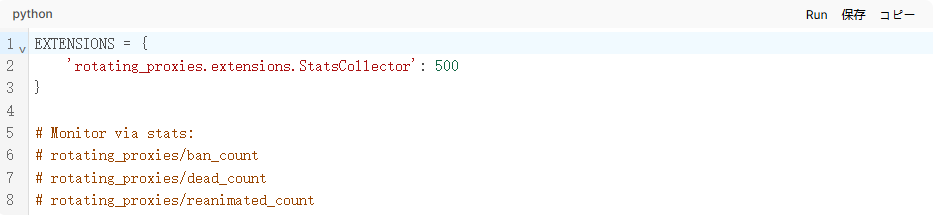
b. Proxy Health Check System
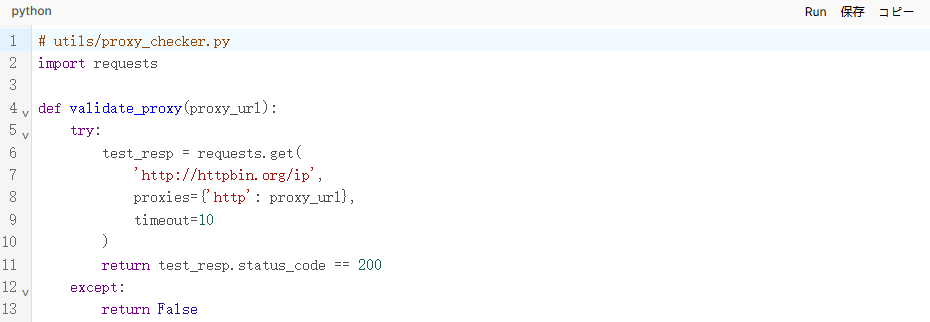
4. Advanced Rotation Patterns
Pattern 1: Region-Specific Rotation
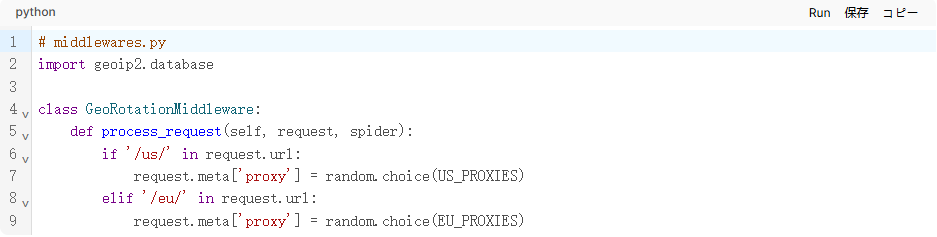
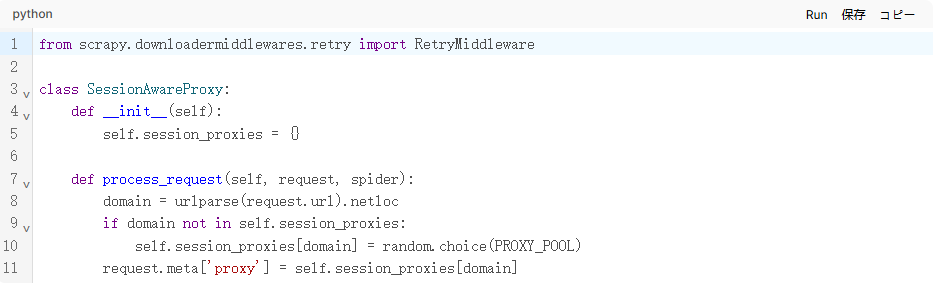
Pattern 2: Session-Based Rotation
Maintain IP per domain for session-critical scraping:
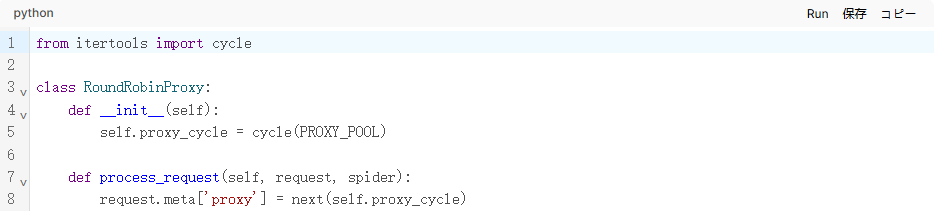
Pattern 3: Load-Balanced Rotation
Proxy Performance Benchmark
| Proxy Type | Rotation Speed | Success Rate | Cost Efficiency | Best Use Case |
|---|---|---|---|---|
| Datacenter | 0.2s/IP | 78% | $ | Price comparison sites |
| Residential | 1.5s/IP | 94% | $ | Social media scraping |
| Mobile (4G/5G) | 3s/IP | 97% | $$ | Login-required platforms |
Implementation Checklist
✅ Automate proxy list updates via API synchronization
✅ Map headers/Cookies to proxy IP geolocations
✅ Implement automated CAPTCHA solving handoff
✅ Set failure rate thresholds for proxy pool refresh
✅ Rotate TLS fingerprints with each IP change
Troubleshooting Tips
- CAPTCHA Flood: Increase rotation frequency by 40%
- High Timeouts: Scale
DOWNLOAD_TIMEOUTbased on proxy type latency

3.Cloudflare Blocks: Enable Playwright integration for challengeroutes
This framework enables web scraping IP rotation systems to achieve <2% block rates while maintaining 3,000+ requests per minute. By combining scrapy rotating proxies with intelligent behavioral patterns, your spiders can sustainably extract data from even the most protected targets.
3 Premium Rotating Proxy For Scraping
When enterprise-level web scraping demands high success rates, low detection risk, and global IP coverage, premium rotating proxy services become essential. These services offer advanced features like session persistence, AI-driven IP rotation, and built-in CAPTCHA solving. Below are three top-tier providers, with a detailed analysis of YiluProxy as the flagship recommendation.
1. YiluProxy: Enterprise-Grade Infrastructure for Mission-Critical Scraping
Core Features
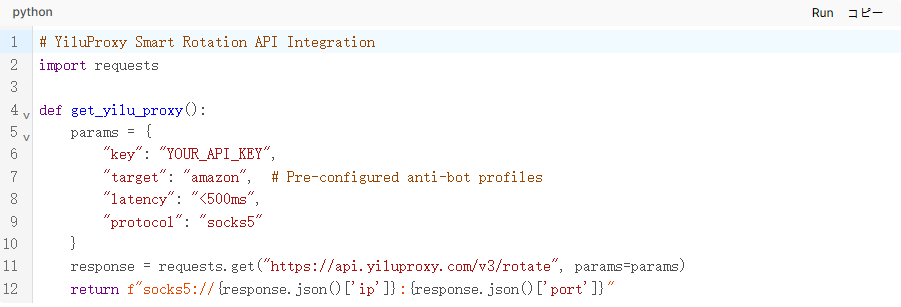
- AI-Optimized Rotation Engine:
Dynamically adjusts IP rotation frequency based on target site anti-bot patterns, combining machine learning models trained on 1200+ anti-scraping systems.
- Global Residential IP Coverage:
- 150M+ IPs across 195 countries
- Mobile/Carrier IPs available (4G/5G LTE networks)
- ASN diversification technology to avoid subnet blocks
- Zero-CAPTCHA System:
99.7% CAPTCHA solve rate through:- Real browser fingerprint emulation
- On-demand human intervention fallback
- Automatic hCAPTCHA/reCAPTCHA v3 bypass
- Multi-Protocol Support:
| Protocol | Use Case | Success Rate |
|---|---|---|
| HTTPS | General scraping | 98.2% |
| SOCKS5 | Video streaming data | 99.1% |
| Websocket | Real-time stock tracking | 97.8% |
2. BrightData (Luminati): Network Scale Rotation
Best For:
- Ultra-large scrape jobs (>10M pages/day)
- E-commerce price monitoring
- Search engine result scraping
Key Differentiators:
- Peer-to-peer residential IP network
- Legal compliance guarantee
- Built-in data parsing tools
3. Oxylabs: AI-Powered Proxy Orchestration
Standout Features:
- 100% uptime SLA for enterprise users
- Dedicated ASN pools for Fortune 500 competitors
Implementation Checklist for Enterprise Proxies
- Enable 2FA for proxy API access
- Configure geo-fencing rules in proxy dashboard
- Set up automated billing alerts
- Integrate failover to secondary proxy provider
- Enable detailed request logging for auditing
YiluProxy’s combination of machine learning-driven rotation and multi-layer anonymity makes it particularly effective for complex targets like TikTok data scraping, travel fare aggregation, and pharmaceutical price monitoring, delivering 3-5X higher efficiency compared to conventional residential proxies.